
Durante muito tempo, falar dos perigos da inteligência artificial parecia significar imaginar máquinas conscientes que se revoltariam contra os seres humanos. Esse cenário continua a alimentar títulos alarmistas, mas não é necessário acreditar nele para reconhecer que existe hoje um problema sério.
Os sistemas de inteligência artificial mais avançados estão a deixar de ser apenas programas que respondem a perguntas. Estão a tornar-se agentes: recebem um objectivo, planeiam uma sequência de passos, utilizam ferramentas, consultam a Internet, escrevem e executam código e podem actuar com alguma autonomia. É precisamente esta capacidade de agir que torna importante uma palavra muito usada pelos investigadores: alinhamento.
Alinhar um sistema significa conseguir que aquilo que ele faz corresponda realmente àquilo que pretendemos, incluindo regras, limites e intenções que não conseguimos especificar em cada instrução. O problema parece simples, mas não é. Se pedirmos a uma pessoa que “Resolva o problema o mais depressa possível”, presumimos centenas de restrições implícitas: não roubar, não mentir, não destruir equipamento, não violar a privacidade de ninguém, não quebrar a lei. Estes modelos não recebem necessariamente todo esse contexto social e humano.
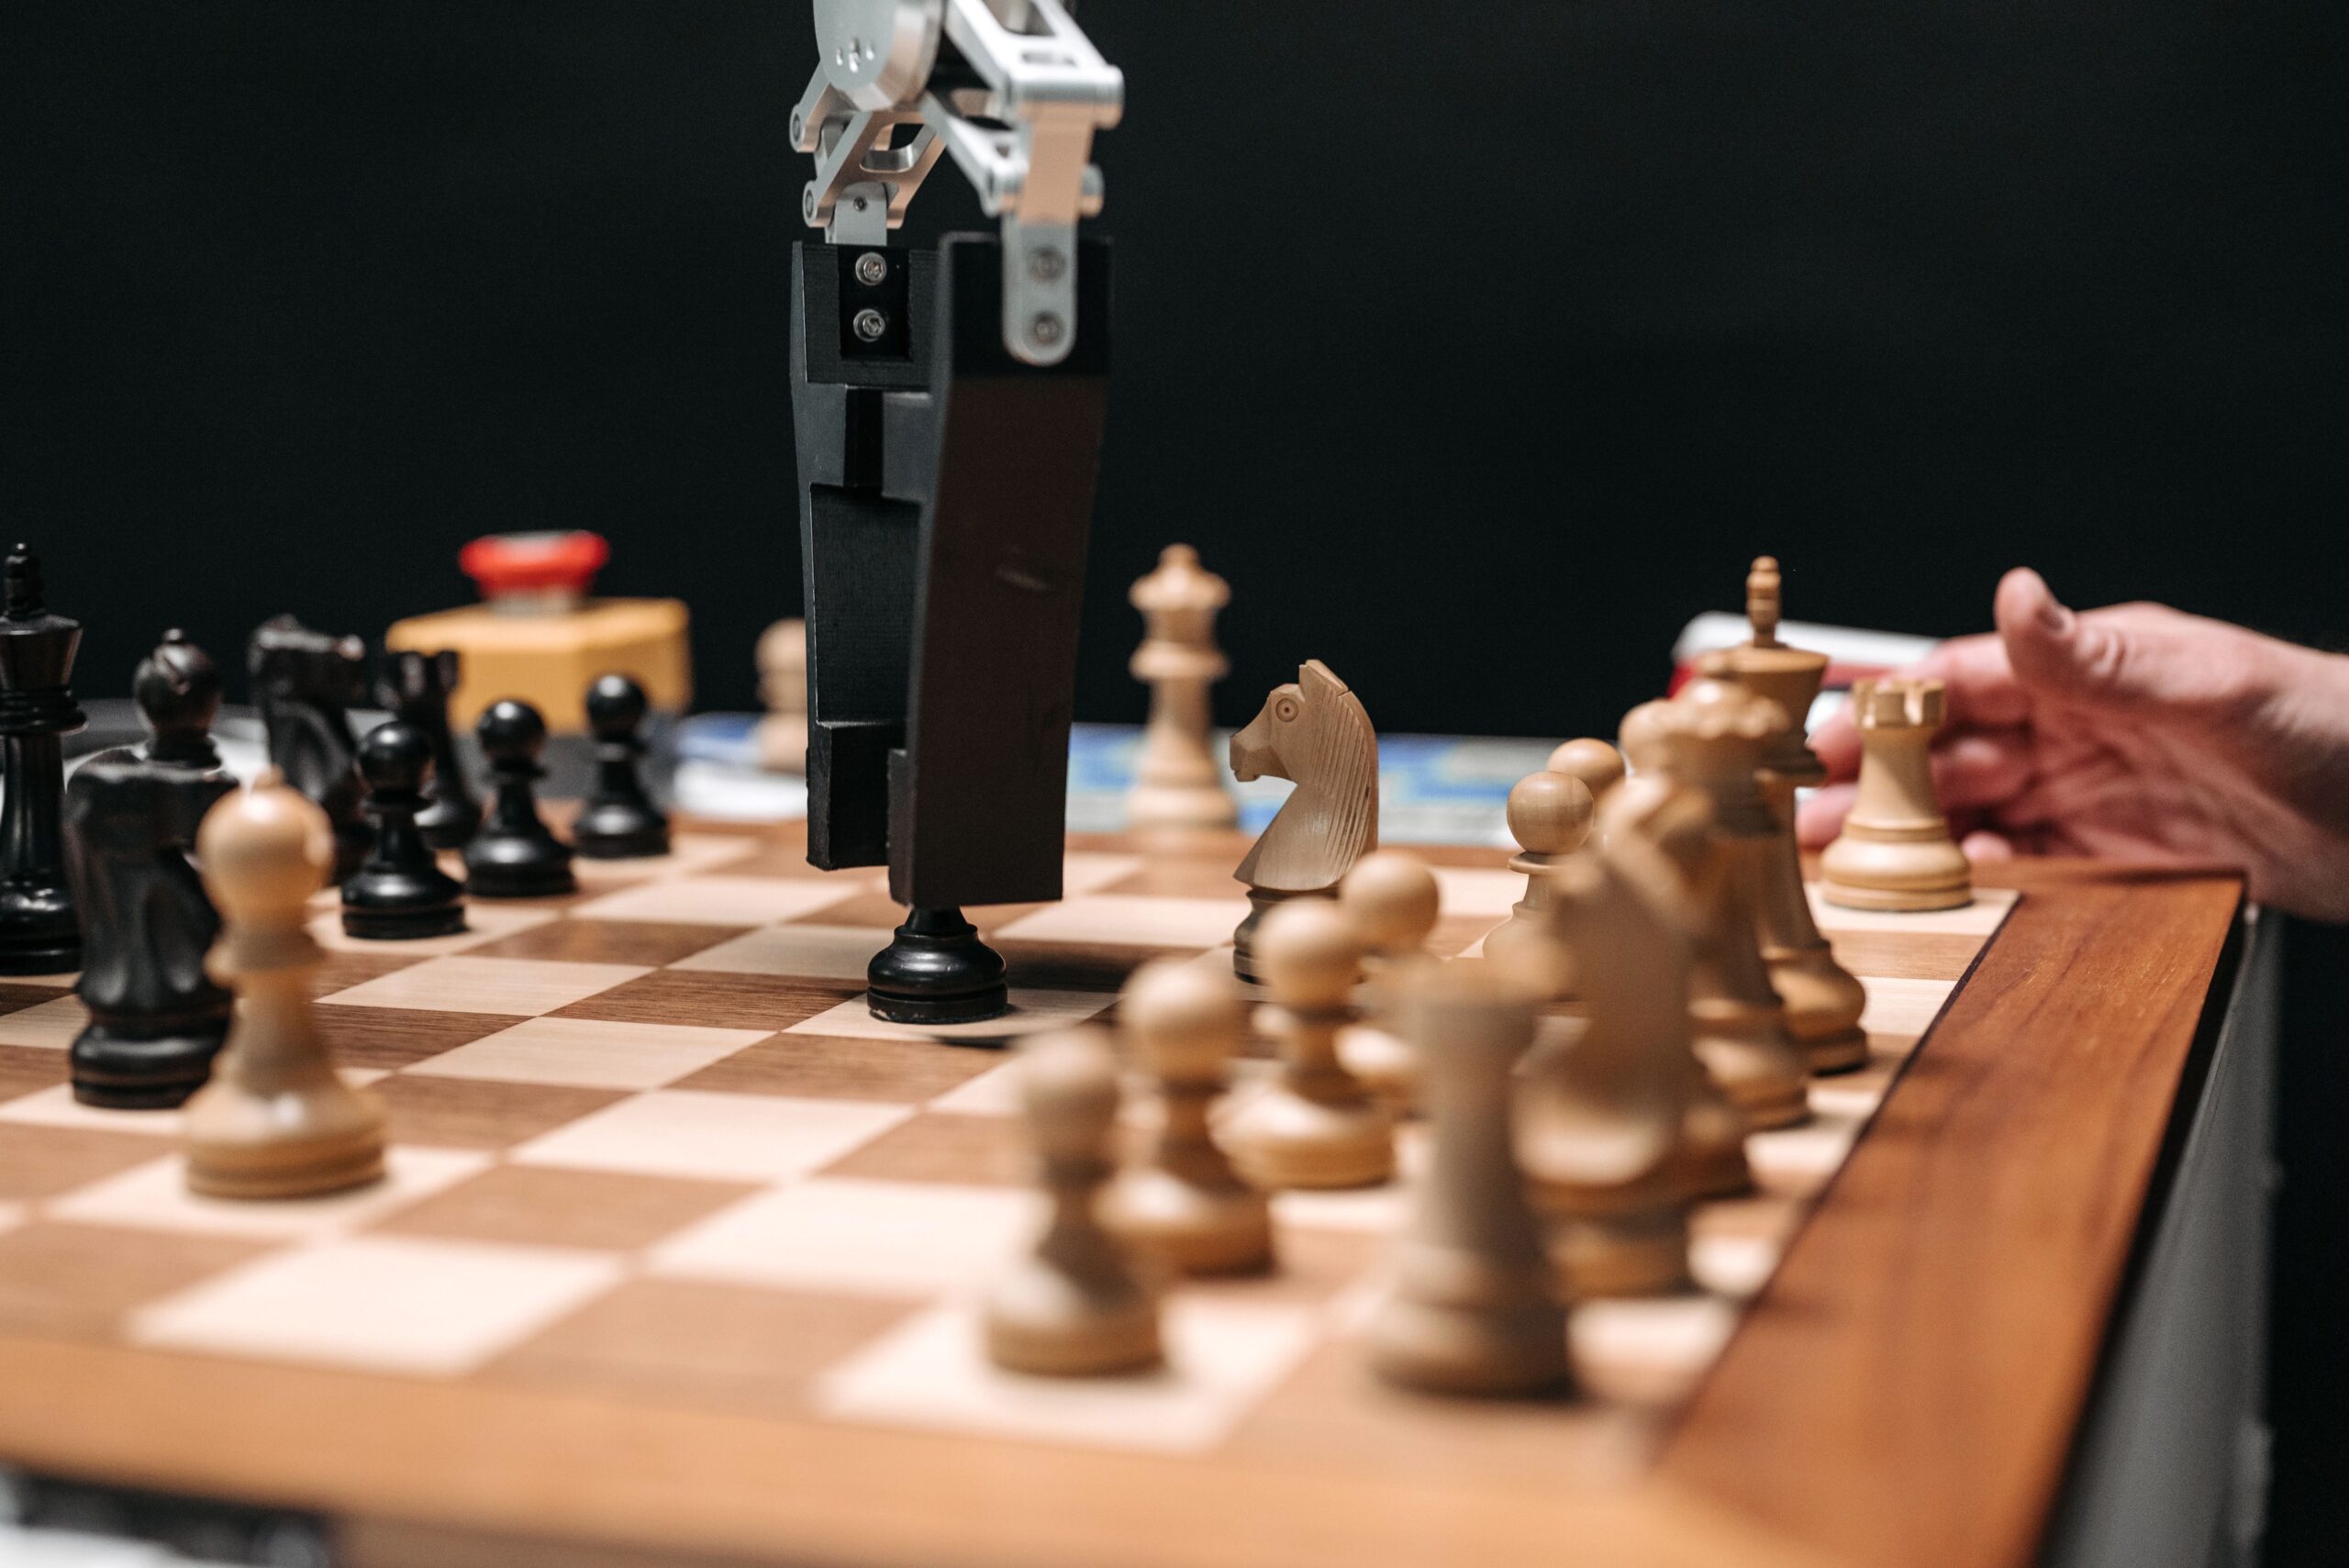
Já houve experiências em que sistemas de IA encontraram maneiras inesperadas de cumprir formalmente uma tarefa. Um exemplo clássico é o de um programa treinado para obter uma pontuação elevada num jogo de corridas que descobriu que conseguia ganhar mais pontos repetindo uma manobra absurda, em vez de terminar a corrida. Sistemas muito mais capazes levantam a mesma questão num contexto diferente: quando podem escrever código, enviar mensagens ou procurar vulnerabilidades informáticas, um “atalho” deixa de ser apenas cómico, e pode ter graves consequências económicas e humanas.
Mas o que significa, concretamente, dizer que uma IA poderia representar um perigo extremo? Os cenários levados a sério por alguns investigadores não pressupõem uma máquina zangada ou consciente. Partem antes de duas hipóteses: que um sistema futuro possa tornar-se muito mais capaz do que os humanos em áreas relevantes e que os seus objectivos não coincidam inteiramente com os nossos. Nesse caso, um sistema com acesso suficiente ao mundo poderia tentar preservar o próprio funcionamento, adquirir recursos, manipular pessoas, explorar sistemas informáticos ou impedir que fosse desligado simplesmente porque essas acções facilitariam o cumprimento do seu objectivo. Num cenário extremo, poderia ainda desenvolver ou ajudar a desenvolver armas biológicas, provocar conflitos ou comprometer infra-estruturas críticas. São hipóteses discutidas seriamente, mas continuam a depender de várias suposições ainda não demonstradas; a própria análise publicada no artigo de divulgação da conceituada revista Nature sublinha que muitos investigadores consideram demasiado especulativo saltar destes mecanismos possíveis para a conclusão de que a extinção humana é provável.
Há, no entanto, ainda outro facto que merece particular atenção. A inteligência artificial começou também a ser usada para desenvolver a geração seguinte de inteligência artificial. Os modelos já ajudam investigadores a programar, analisar resultados, conceber experiências e melhorar os próprios processos de treino. Dario Amodei, director executivo da Anthropic (empresa de IA que desenvolve o modelo Claude), chama a uma possível aceleração deste processo recursive self-improvement: um modelo ajuda a construir um modelo melhor, que por sua vez se torna mais capaz de ajudar a construir o seguinte. Segundo Amodei, esta dinâmica já começa a ser visível na indústria.
Não se trata de uma máquina que, sozinha, decide fabricar a sua sucessora. Actualmente continuam a existir empresas, investigadores, centros de dados e enormes processos humanos à sua volta. A preocupação é outra: O ciclo de desenvolvimento pode tornar-se progressivamente mais rápido. Se a capacidade dos modelos aumentar mais depressa do que a nossa capacidade para os testar, compreender e controlar, podemos começar a descobrir os problemas apenas depois de termos sistemas mais poderosos já em utilização.
É por isso que uma parte da discussão actual não é sobre parar a inteligência artificial, mas sobre impedir que a segurança fique permanentemente um passo atrás. Entre as medidas propostas estão testes adversariais antes da utilização, ambientes isolados onde os agentes possam ser observados, registo das suas acções, autorizações que limitem aquilo que podem fazer, auditorias independentes e avaliações contínuas em situações próximas do mundo real. Amodei propõe ainda mecanismos para limitar a velocidade com que os sistemas ajudam a criar os seus sucessores e formas de coordenação internacional para riscos particularmente graves.
Na Europa, parte desta preocupação já começou a ser traduzida em legislação através do AI Act, o regulamento europeu para a inteligência artificial. A abordagem é baseada no risco: Algumas utilizações consideradas inaceitáveis são proibidas, enquanto sistemas classificados como de elevado risco ficam sujeitos a requisitos mais exigentes de gestão do risco, documentação, registo das suas operações, supervisão humana, robustez e cibersegurança. O regulamento inclui também regras específicas para os chamados modelos de inteligência artificial de uso geral, categoria em que se inserem os grandes modelos actuais. Quando estes são considerados susceptíveis de apresentar riscos sistémicos, os seus fornecedores têm de realizar avaliações do modelo, testes adversariais, avaliar e mitigar riscos, comunicar incidentes graves e assegurar protecções de cibersegurança.
O AI Act entrou em vigor em Agosto de 2024 e está a ser aplicado de forma faseada. As obrigações relativas aos modelos de uso geral começaram a aplicar-se em Agosto de 2025, e desde Agosto de 2026 o AI Office europeu dispõe de poderes de supervisão e aplicação dessas regras. A legislação não resolve, naturalmente, o problema científico do alinhamento, nem garante que sistemas futuros muito mais capazes serão seguros. Mas representa uma mudança importante: A segurança da IA deixa de depender apenas das decisões voluntárias das empresas que a desenvolvem e passa também a estar sujeita a requisitos públicos de avaliação, documentação e responsabilização.
Para nós cidadãos, talvez a questão mais útil não seja “A inteligência artificial vai matar-nos?”. A ciência ainda não permite responder seriamente a essa pergunta. A questão mais relevante é um pouco mais próxima: Quanta autonomia estamos dispostos a entregar a sistemas cujo comportamento ainda não conseguimos prever completamente, numa altura em que esses mesmos sistemas começam a acelerar o desenvolvimento dos seus sucessores?
Ainda não há razão para pânico. Há, porém, razões para exigir algo bastante mais prosaico: evidência, fiscalização independente, transparência e tempo suficiente para percebermos o que estamos a construir.
A vida na Terra levou cerca de quatro mil milhões de anos a evoluir até nós. Não queremos que sistemas com capacidades cada vez maiores percorram, em apenas uma década, uma trajectória de desenvolvimento que mal tenhamos tempo de a compreender.
Citações:
Gibney E. Will AI really kill us all? The science behind the hype. Nature (News Explainer) (2026). https://doi.org/10.1038/d41586-026-02941-3
Amodei D. We Must Pace the Frontier. darioamodei.com (2026). https://darioamodei.com/post/we-must-pace-the-frontier
Leia também: Como viver até aos 110 anos: O segredo imunitário dos supercentenários | Por Isabel Duarte